
MCP staje się bezstanowy: Co zmienia protokół 2026 dla deweloperów agentów AI
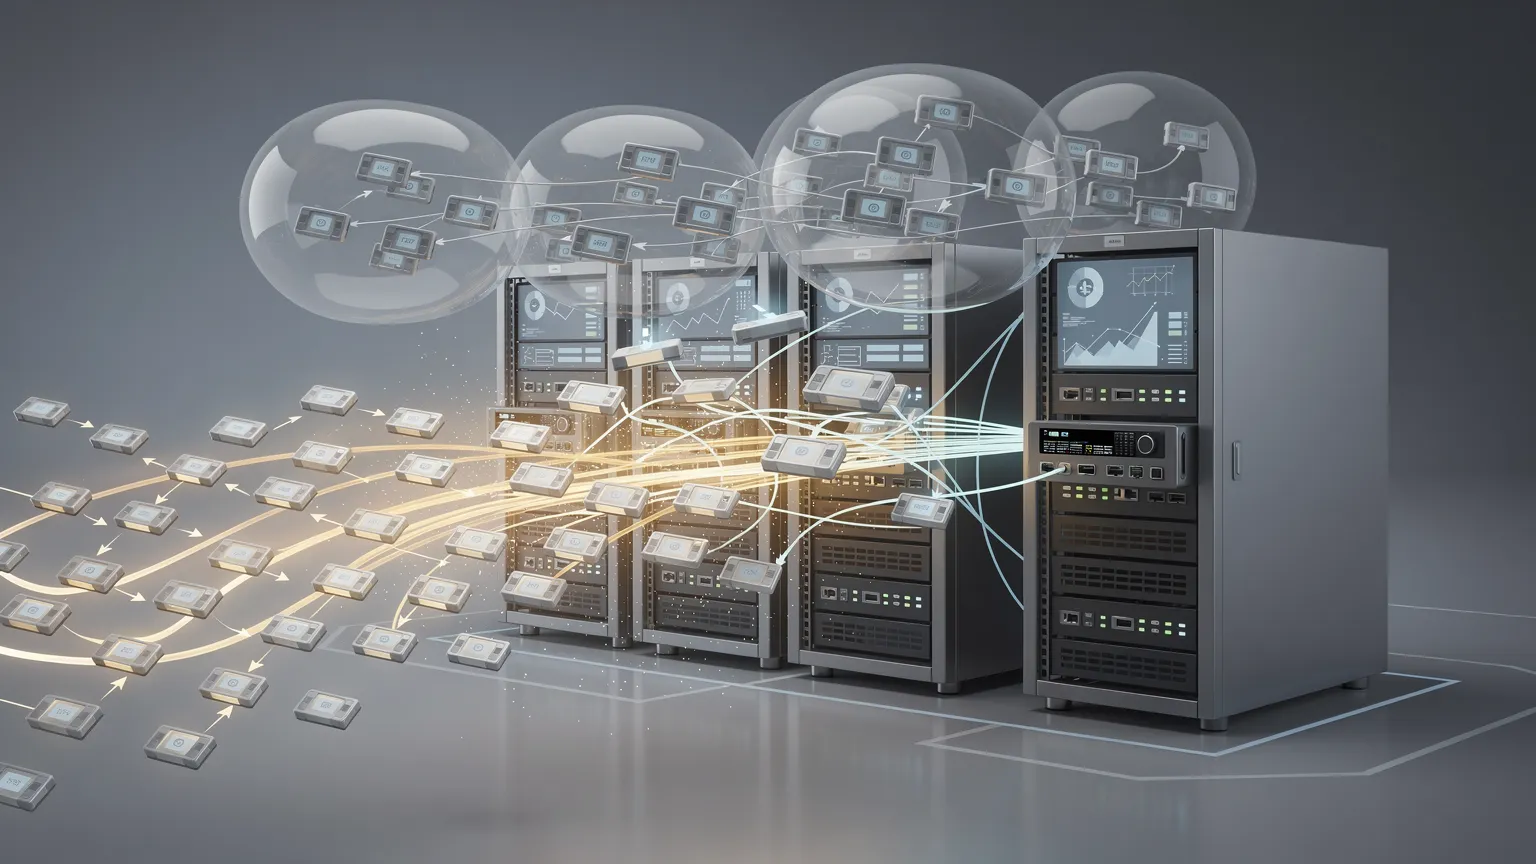
Protokół Model Context przeszedł poza swoją pierwotną architekturę opartą na sesjach. Specyfikacja z 28.07.2026 sprawia, że MCP jest bezstanowy, łatwiejszy do skalowania za pomocą standardowej infrastruktury HTTP oraz lepiej przystosowany do agentów AI w produkcji. Oto, co się zmieniło, dlaczego to ważne i co deweloperzy powinni sprawdzić w istniejących serwerach MCP.
Model Context Protocol (MCP) szybko ewoluował z wygodnego sposobu łączenia modeli AI z narzędziami i danymi w solidowy element infrastruktury agentów.
Ta ewolucja stworzyła problem.
Pierwsze generacje zdalnych serwerów MCP były zaprojektowane wokół sesji na poziomie protokołu. Klient inicjował połączenie, serwer wydawał identyfikator sesji, a kolejne żądania pozostawały powiązane z tą sesją.
To działa dobrze, gdy klient AI rozmawia z pojedynczym procesem serwera. Staje się mniej atrakcyjne, gdy ta sama usługa MCP musi działać w wielu kontenerach, regionach lub instancjach w chmurze.
Specyfikacja MCP 2026-07-28 fundamentalnie zmienia tę architekturę: nowoczesny cykl życia MCP jest bezstanowy na poziomie protokołu.
Dla deweloperów budujących produkcyjne agenty AI, to więcej niż szczegół protokołu. Zmienia to sposób wdrażania, skalowania i integrowania usług MCP z konwencjonalną infrastrukturą HTTP.
Dlaczego MCP musiał stać się bezstanowy
Wcześniejsze wersje MCP używały uzgadniania w ramach inicjalizacji. Klient łączył się z serwerem MCP, wysyłał żądanie initialize i negocjował możliwości oraz wersję protokołu. Z Streamable HTTP serwer mógł również wydać Mcp-Session-Id, który identyfikował sesję w późniejszych żądaniach.
Jeśli kilka instancji serwera MCP znajduje się za modułem równoważenia obciążenia, infrastruktura może więc wymagać routingu lepkiego (sticky routing) lub współdzielonego przechowywania sesji. Nowa architektura usuwa to wymaganie z samego protokołu.
Co zmieniło się w MCP 2026-07-28?
Sesja na poziomie protokołu znika z nowoczesnego cyklu życia. Uzgadnianie initialize używane w poprzedniej erze protokołu nie jest już częścią tego cyklu życia, a mechanizm Mcp-Session-Id został usunięty.
Zamiast tego nowoczesni klienci odkrywają serwer i wysyłają żądania zawierające wystarczające informacje protokołu, aby mogły zostać przetworzone niezależnie. Praktyczny wynik jest ważny: żądanie A i żądanie B nie muszą już trafić do tej samej instancji serwera MCP tylko dlatego, że należą do tej samej sesji protokołu.
Konwencjonalny moduł równoważenia obciążenia może je rozdzielić między dostępne instancje.
Bezstanowy MCP nie oznacza bezstanowe aplikacje
Usunięcie sesji protokołu MCP nie oznacza, że aplikacja nie może już utrzymać stanu.
Wyobraź sobie narzędzie MCP, które tworzy koszyk zakupowy. Zamiast przechowywać ukryty koszyk wewnątrz sesji MCP, narzędzie może zwrócić jawy identyfikator:
basket_id: basket_84721Późniejsze wywołanie narzędzia może przyjąć ten identyfikator:
add_item(
    basket_id: "basket_84721",
    product_id: "product_42"
)
Stan nadal istnieje. Po prostu należy do aplikacji, a nie do protokołu transportowego. Ten wzorzec będzie znany deweloperom webowym: API RESTowe rutynowo udostępniają identyfikatory dla koszyków, zadań, rozmów, plików lub przepływów pracy zamiast oczekiwać, że samo połączenie HTTP zapamięta stan aplikacji.
Dlaczego to ma znaczenie dla skalowania poziomego
Rozważ zdalny serwer MCP działający na trzech instancjach aplikacji:
AI client
    |
Load balancer
    |
+---------+---------+
|         |         |
MCP #1   MCP #2   MCP #3
Ze stanem sesji na poziomie protokołu, infrastruktura może musieć utrzymać konkretnego klienta przyłączonego do jednej instancji lub replikować dane jego sesji. Z nowoczesnym bezstanowym cyklem życia każde kompatybilne żądanie może zostać obsłużone niezależnie.
To ułatwia stosowanie równoważenia obciążenia round-robin, autoskalowania, kontenerów efemerycznych, wdrożeń rolling, środowisk serverless i wdrożeń wieloinstancyjnych Kubernetes.
Odkrywanie zastępuje część starego modelu inicjalizacji
Jeśli nie ma długotrwałej wymiany inicjalizacyjnej, klient wciąż musi wiedzieć, co obsługuje serwer. Nowy cykl życia wprowadza odkrywanie serwera.
Zamiast polegać na informacjach negocjowanych raz i przechowywanych jako stan sesji, nowoczesne implementacje MCP mogą uwidaczniać swoje możliwości poprzez model odkrywania. Specyfikacja 2026 wprowadza również informacje TTL dla wyników list, pozwalając klientom wiedzieć, jak długo odkryte informacje mogą zostać rozsądnie ponownie wykorzystane.
W dużych wdrożeniach buforowanie niezmiennych list narzędzi zmniejsza niepotrzebne narzuty.
Interakcje serwer-klient musiały też się zmienić
Przejście na bezstanowość tworzy trudniejszy wyzwanie dla interakcji inicjowanych przez serwer. Załóżmy, że narzędzie wykonuje się i potrzebuje dodatkowych informacji od użytkownika.
Architektura MCP 2026 wprowadza Wielokrotne Żądania Round-Trip (MRTR), aby wspierać interakcje wymagające dodatkowego wejścia klienta bez przywracania trwałej sesji protokołu.
Żądania inicjowane przez serwer muszą być również skojarzone z aktywnym żądaniem klienta. To ułatwia rozumowanie o interakcjach zarówno z perspektywy infrastruktury, jak i bezpieczeństwa.
MCP staje się łatwiejszy do zrozumienia dla bram (gateways)
Nowoczesne żądania MCP mogą uwidaczniać informacje routingu w nagłówkach HTTP, w tym informacje o wywoływanej metodzie MCP. Brama API lub limiter szybkości może więc podejmować decyzje bez parsowania każdego ciała JSON-RPC.
Dla zespołów infrastruktury otwiera to drzwi do konwencjonalnego routingu, obserwowalności, limitów, ograniczania szybkości i analizy ruchu.
Praca Google nad Apigee ilustruje ten kierunek: infrastruktura bram może uwidaczniać operacje ze specyfikacji OpenAPI jako narzędzia MCP i obsługiwać tłumaczenie protokołu zamiast wymagać zupełnie oddzielnego stosu MCP.
Bezpieczeństwo staje się priorytetem wdrożeniowym
Skalowanie MCP jest przydatne tylko wtedy, gdy dostęp do narzędzi może być również bezpiecznie kontrolowany.
Prace z 2026 roku obejmują wzmocnienie autoryzacji wokół koncepcji OAuth i OpenID Connect, w tym silniejszą walidację wystawcy, izolację poświadczeń i obsługę zakresów.
Szersze ekosystemy dodają również kontrole administracyjne wokół tego, które serwery MCP mogą być używane. GitHub, na przykład, wprowadził listy dozwolonych (allowlisty) MCP dla przedsiębiorstw w sierpniu 2026 roku, aby administratorzy mogli centralnie kontrolować serwery MCP używane przez obsługiwane klienty GitHub Copilot.
Serwery MCP mogą udostępniać bazy danych, systemy wdrażania, aplikacje biznesowe lub inne uprzywilejowane możliwości agentowi AI. Uwierzytelnianie, autoryzacja, uprawnienia narzędzi i możliwość audytu dlatego należą do architektury.
Czy istniejące serwery MCP muszą zostać przepisane?
Niekoniecznie.
Przejście jest wspierane przez oficjalne SDK. Implementacje mogą obsługiwać nowoczesny ruch, zachowując zachowanie kompatybilności dla klientów z wcześniejszej ery protokołu, co pozwala na stopniową, a nie nagłą migrację.
Sensowną strategią migracji jest ustalenie, czy istniejący serwer MCP faktycznie zależy od sesji protokołu. Konwencjonalne narzędzia request/response mogą być proste do migracji. Dane objęte zakresem sesji, subskrypcje lub starsze zachowania serwer-klient mogą wymagać większej pracy architektonicznej.
Co deweloperzy powinni przejrzeć teraz
Jeśli utrzymujesz serwer MCP, przejrzyj pięć obszarów.
Po pierwsze, zidentyfikuj dane aplikacji przechowywane niejawnie w sesji MCP i ustal, czy powinny one zamiast tego mieć jawny identyfikator aplikacji.
Po drugie, sprawdź wersję swojego SDK MCP i wsparcie dla rewizji protokołu 2026-07-28.
Po trzecie, przejrzyj interakcje serwer-klient i wdroż nowszy model round-trip tam, gdzie jest wymagany.
Po czwarte, przejrzyj uwierzytelnianie i autoryzację zamiast traktować migrację protokołu jako zmianę tylko transportową.
Na koniec, przetestuj za modułem równoważenia obciążenia z więcej niż jedną instancją aplikacji. Kolejne żądania powinny bezpiecznie trafić do różnych instancji.
MCP staje się infrastrukturą, a nie tylko protokołem deweloperskim
MCP zaczął się jako warstwa interoperacyjności między modelami a zewnętrznymi możliwościami. Jest teraz adoptowany w narzędziach deweloperskich AI, platformach chmurowych i ekosystemach agentów.
Google zintegrował MCP z produktami deweloperskimi i API, podczas gdy SDK Apps OpenAI opiera się na MCP, aby łączyć zewnętrzne narzędzia i dane z interaktywnymi doświadczeniami w ChatGPT.
Jak rozrasta się adopcja, infrastruktura MCP musi wspierać obciążenia bardzo inne od lokalnych integracji, dla których early implementacje były zoptymalizowane.
Utworzenie bezstanowego rdzenia protokołu jest więc ważnym krokiem dojrzewania.
Dla deweloperów wniosek jest prosty: serwer MCP powinien być coraz częściej projektowany jak skalowalna usługa webowa, z jawnym stanem aplikacji, jasnymi granicami autoryzacji i infrastrukturą, która nie zależy od jednej długotrwałej sesji protokołu.
To sprawia, że MCP jest mniej nietypowy w obsłudze – i znacznie bardziej praktyczny dla następnego pokolenia produkcyjnych agentów AI.