
MCP diventa stateless: Come cambierà il protocollo 2026 per gli sviluppatori di agenti AI
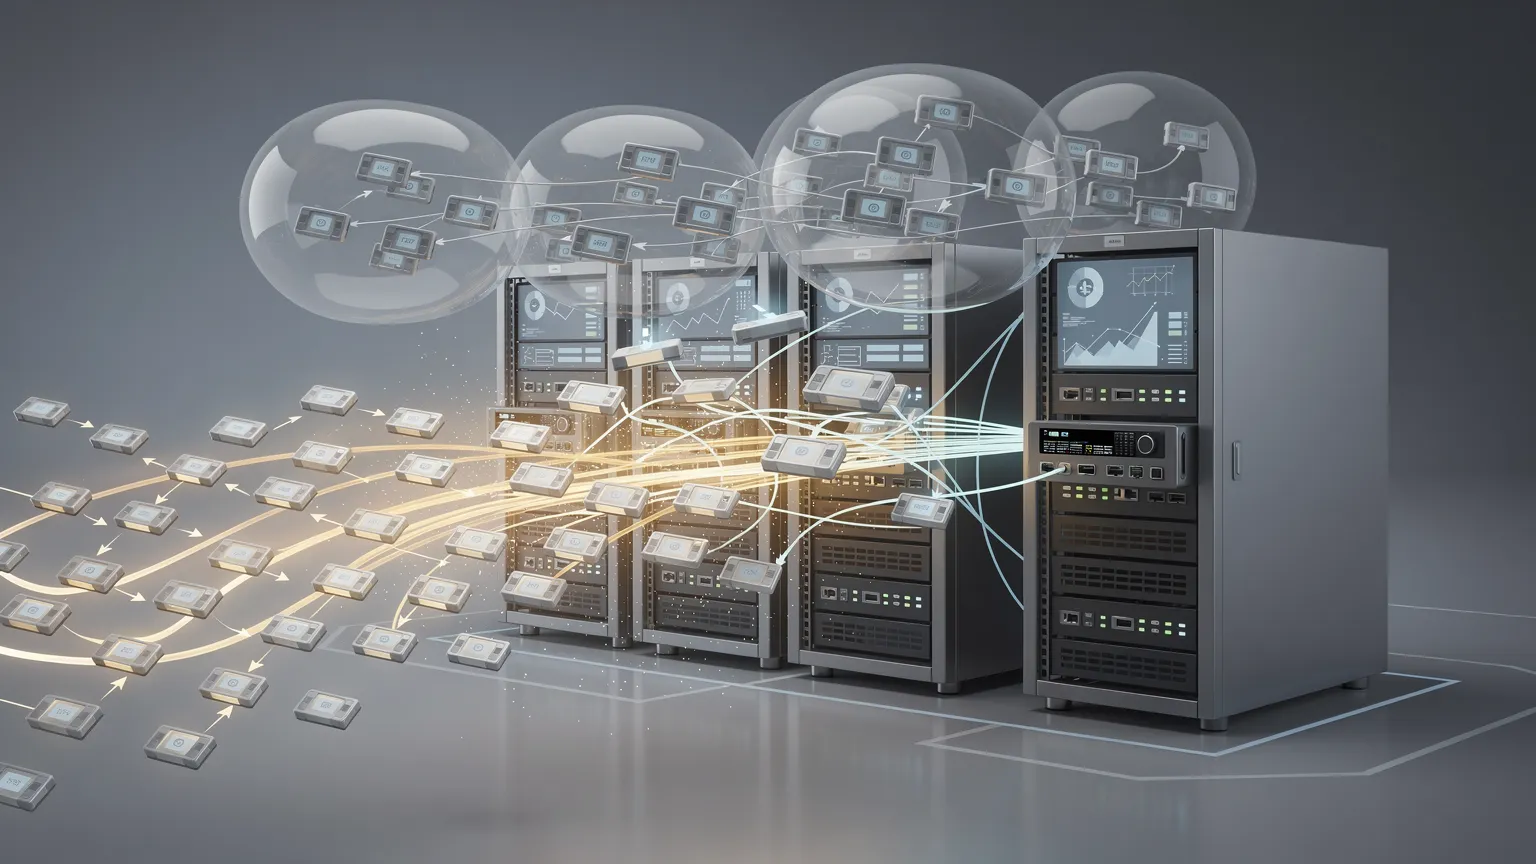
Il Protocollo di Contesto del Modello è passato oltre la sua architettura originale basata su sessioni. La specifica 2026-07-28 rende MCP stateless, più facile da scalare dietro l'infrastruttura HTTP standard e più adatto agli agenti AI in produzione. Ecco cosa è cambiato, perché è importante e cosa gli sviluppatori dovrebbero rivedere nei server MCP esistenti.
Il Model Context Protocol si è evoluto rapidamente da un modo conveniente per connettere modelli di AI a strumenti e dati a una componente seria dell'infrastruttura per agenti.
Questa evoluzione ha creato un problema.
Le prime generazioni di server MCP remoti erano progettate attorno a sessioni a livello di protocollo. Un client inizializzava una connessione, il server rilasciava un identificatore di sessione e le richieste successive rimanevano associate a quella sessione.
Funziona bene quando un client di AI comunica con un singolo processo server. Diventa meno interessante quando lo stesso servizio MCP deve essere eseguito su più container, regioni o istanze cloud.
La specifica MCP 2026-07-28 cambia radicalmente quell'architettura: il ciclo di vita moderno di MCP è senza stato a livello di protocollo.
Per gli sviluppatori che creano agenti di AI in produzione, questo è più di un dettaglio di protocollo. Cambia il modo in cui i servizi MCP possono essere distribuiti, scalati e integrati con l'infrastruttura HTTP convenzionale.
Perché MCP ha dovuto diventare senza stato
Le versioni precedenti di MCP utilizzavano uno scambio di inizializzazione. Un client si connetteva a un server MCP, inviava una richiesta initialize e negoziava capacità e una versione del protocollo. Con Streamable HTTP, un server poteva anche rilasciare un Mcp-Session-Id che identificava la sessione nelle richieste successive.
Se diverse istanze di server MCP si trovano dietro un load balancer, l'infrastruttura potrebbe quindi richiedere instradamento persistente o archiviazione condivisa delle sessioni. La nuova architettura rimuove tale requisito dal protocollo stesso.
Cosa è cambiato in MCP 2026-07-28?
La sessione a livello di protocollo scompare dal ciclo di vita moderno. Lo scambio initialize utilizzato dalla precedente era del protocollo non fa più parte di tale ciclo di vita, e il meccanismo Mcp-Session-Id è stato rimosso.
Invece, i client moderni scoprono un server e inviano richieste contenenti informazioni di protocollo sufficienti per essere elaborate in modo indipendente. Il risultato pratico è importante: la richiesta A e la richiesta B non devono più raggiungere la stessa istanza del server MCP semplicemente perché appartengono alla stessa sessione di protocollo.
Un load balancer convenzionale può distribuirle tra le istanze disponibili.
MCP senza stato non significa applicazioni senza stato
Rimuovere la sessione di protocollo di MCP non significa che un'applicazione non può più mantenere lo stato.
Immagina uno strumento MCP che crea un carrello della spesa. Invece di memorizzare un carrello nascosto all'interno di una sessione MCP, lo strumento può restituire un identificatore esplicito:
basket_id: basket_84721Una successiva chiamata allo strumento può accettare quell'identificatore:
add_item(
    basket_id: "basket_84721",
    product_id: "product_42"
)
Lo stato esiste ancora. Appartiene semplicemente all'applicazione piuttosto che al protocollo di trasporto. Questo modello risulterà familiare agli sviluppatori web: le API REST espongono di routine identificatori per carrelli, processi, conversazioni, file o flussi di lavoro invece di aspettarsi che una connessione HTTP ricordi lo stato dell'applicazione.
Perché questo è importante per lo scaling orizzontale
Considera un server MCP remoto in esecuzione su tre istanze di applicazione:
AI client
    |
Load balancer
    |
+---------+---------+
|         |         |
MCP #1   MCP #2   MCP #3
Con lo stato di sessione a livello di protocollo, l'infrastruttura potrebbe dover mantenere un particolare client collegato a un'istanza o replicare i dati della sua sessione. Con il ciclo di vita moderno senza stato, ogni richiesta compatibile può essere gestita in modo indipendente.
Questo rende più facili da applicare il bilanciamento del carico round-robin, l'autoscaling, i container effimeri, i deployment rolling, i runtime serverless e i deployment Kubernetes multi-istanza.
La scoperta sostituisce parte del vecchio modello di inizializzazione
Se non c'è uno scambio di inizializzazione di lunga durata, un cliente ha comunque bisogno di sapere cosa supporta il server. Il nuovo ciclo di vita introduce la scoperta del server.
Invece di fare affidamento su informazioni negoziate una volta e conservate come stato di sessione, le implementazioni MCP moderne possono esporre le proprie capacità attraverso il modello di scoperta. La specifica 2026 introduce anche informazioni TTL per i risultati di elenco, consentendo ai client di sapere per quanto tempo le informazioni scoperte possono essere ragionevolmente riutilizzate.
Per i deployment su larga scala, la memorizzazione nella cache degli elenchi di strumenti invariati riduce overhead non necessario.
Anche le interazioni da server a client dovevano cambiare
Diventare senza stato crea una sfida più difficile per le interazioni avviate dal server. Supponi che uno strumento stia eseguendo e abbia bisogno di informazioni aggiuntive dall'utente.
L'architettura MCP 2026 introduce Multi Round-Trip Requests (MRTR) per supportare interazioni che richiedono input aggiuntivo dal client senza ripristinare una sessione di protocollo permanente.
Anche le richieste avviate dal server devono essere associate a una richiesta client attiva. Ciò rende le interazioni più facili da analizzare sia da una prospettiva di infrastruttura che di sicurezza.
MCP sta diventando più facile da comprendere per i gateway
Le richieste MCP moderne possono esporre informazioni di instradamento nelle intestazioni HTTP, incluse informazioni sul metodo MCP invocato. Un gateway API o un limitatore di frequenza può quindi prendere decisioni senza analizzare ogni corpo JSON-RPC.
Per i team di infrastruttura, questo apre la porta a instradamento convenzionale, osservabilità, quote, limitazione della frequenza e analisi del traffico.
Il lavoro di Google su Apigee illustra quella direzione: l'infrastruttura del gateway può esporre operazioni da una specifica OpenAPI come strumenti MCP e gestire la traduzione del protocollo invece di richiedere uno stack MCP completamente separato.
La sicurezza sta diventando una preoccupazione di deployment di primo livello
Lo scaling di MCP è utile solo se l'accesso agli strumenti può essere controllato in modo sicuro.
Il lavoro 2026 include il rafforzamento dell'autorizzazione attorno ai concetti OAuth e OpenID Connect, inclusa una convalida dell'emittente più forte, l'isolamento delle credenziali e la gestione degli ambiti.
L'ecosistema più ampio sta anche aggiungendo controlli amministrativi su quali server MCP possono essere utilizzati. GitHub, ad esempio, ha introdotto allowlist MCP enterprise nell'agosto 2026 in modo che gli amministratori possano controllare centralmente i server MCP utilizzati dai client GitHub Copilot supportati.
I server MCP possono esporre database, sistemi di deployment, applicazioni aziendali o altre capacità privilegiate a un agente di AI. Autenticazione, autorizzazione, autorizzazioni degli strumenti e auditabilità appartengono quindi all'architettura.
I server MCP esistenti devono essere riscritti?
Non necessariamente.
La transizione è supportata da SDK ufficiali. Le implementazioni possono supportare il traffico moderno mantenendo comportamenti di compatibilità per i client dell'era precedente del protocollo, consentendo una migrazione graduale invece di una migrazione "flag-day".
Una strategia di migrazione sensata è determinare se un server MCP esistente dipende effettivamente dalle sessioni di protocollo. Gli strumenti request/response convenzionali possono essere semplici da migrare. I dati con ambito di sessione, le sottoscrizioni o il comportamento da server a client più datato potrebbero richiedere più lavoro architettonico.
Cosa gli sviluppatori dovrebbero esaminare ora
Se mantieni un server MCP, controlla cinque aree.
Primo, identifica i dati dell'applicazione memorizzati implicitamente rispetto a una sessione MCP e determina se dovrebbero invece avere un identificatore applicativo esplicito.
Secondo, controlla la versione del tuo SDK MCP e il supporto per la revisione del protocollo 2026-07-28.
Terzo, esamina le interazioni da server a client e adotta il modello round-trip più recente dove richiesto.
Quarto, esamina l'autenticazione e l'autorizzazione invece di trattare la migrazione del protocollo come un cambiamento solo di trasporto.
Infine, testa dietro più di un'istanza di applicazione. Le richieste consecutive dovrebbero raggiungere in modo sicuro istanze diverse.
MCP sta diventando infrastruttura, non solo un protocollo per sviluppatori
MCP è nato come strato di interoperabilità tra modelli e capacità esterne. Ora viene adottato in strumenti di sviluppo AI, piattaforme cloud ed ecosistemi di agenti.
Google ha integrato MCP in prodotti e API per sviluppatori, mentre l'Apps SDK di OpenAI è basato su MCP per combinare strumenti e dati esterni con esperienze interattive all'interno di ChatGPT.
Man mano che l'adozione si espande, l'infrastruttura MCP deve supportare carichi di lavoro molto diversi dalle integrazioni locali per cui le prime implementazioni erano ottimizzate.
Rendere senza stato il core del protocollo è quindi un importante passo di maturazione.
Per gli sviluppatori, il messaggio chiave è semplice: un server MCP dovrebbe essere progettato sempre più come un servizio web scalabile, con stato applicativo esplicito, confini di autorizzazione chiari e infrastruttura che non dipende da una singola sessione di protocollo di lunga durata.
Ciò rende MCP meno insolito da gestire—e considerevolmente più pratico per la prossima generazione di agenti di AI in produzione.