
Calcolatore di Costi Token API AI: Stima Costi di Input e Output
Stima la spesa delle API AI dai token di input e output, dal volume delle richieste e dai tassi dei modelli, con esempi pratici e modi per ridurre i costi.
Stima il costo di un'API di AI prima di distribuirla
Enter the rates published by your provider. Cached tokens, free tiers, batch discounts and taxes are excluded.
Il prezzo pubblicizzato di un modello di AI è solitamente espresso per milione di token di input e per milione di token di output. Queste tariffe possono differire in modo sostanziale, quindi il costo di una richiesta API dipende sia da quanto contesto invii sia da quanto testo genera il modello.
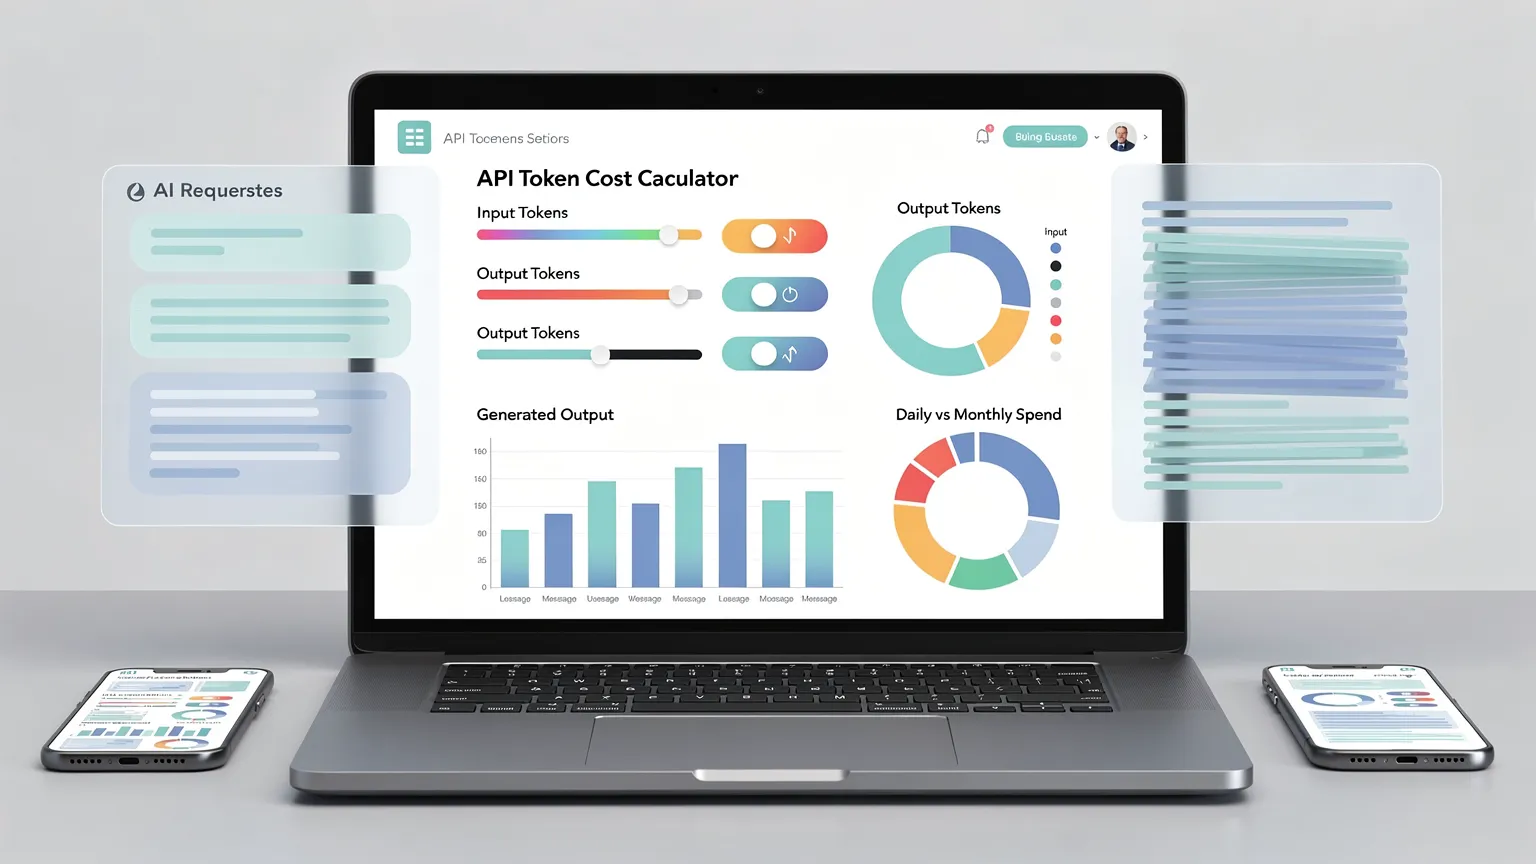
Usa il calcolatore qui sopra per stimare un budget giornaliero o mensile. Sostituisci le tariffe di esempio con i prezzi attuali pubblicati dal provider e dal modello scelti. Il calcolatore non recupera i prezzi in tempo reale.
Passo dopo passo: calcola il tuo budget API
- Misura i token di input. Includi le istruzioni di sistema, il messaggio dell'utente, la cronologia della conversazione, i documenti recuperati e qualsiasi altro testo inviato al modello.
- Misura i token di output. Usa il conteggio effettivo dei token di output delle tue risposte API, oppure stimane il numero da un test rappresentativo.
- Inserisci le richieste al giorno. Parti dall'utilizzo osservato o da una previsione realistica, non da un massimo ottimistico.
- Inserisci i prezzi del provider per milione di token. I prezzi di input e output devono essere inseriti separatamente, in USD per la visualizzazione attuale del calcolatore.
- Confronta la stima con il tuo budget. Ripeti con un numero di richieste più alto e prompt più lunghi per capire la possibile crescita.
La formula di base è:
Costo per richiesta = (token di input ÷ 1,000,000 × tariffa di input) + (token di output ÷ 1,000,000 × tariffa di output).
Moltiplica il risultato per il numero di richieste per stimare i costi totali di utilizzo.
Esempio pratico: un assistente AI per l'assistenza clienti
Supponi che un assistente per l'assistenza usi 2,000 token di input e 500 token di output per richiesta. Solo a scopo illustrativo, supponi che le tariffe siano $1 per milione di token di input e $4 per milione di token di output.
| Voce | Calcolo | Costo |
|---|---|---|
| Input per richiesta | 2,000 ÷ 1,000,000 × $1 | $0.002 |
| Output per richiesta | 500 ÷ 1,000,000 × $4 | $0.002 |
| Totale per richiesta | $0.002 + $0.002 | $0.004 |
| 100 richieste al giorno | 100 × $0.004 | $0.40/giorno |
| Stima su 30 giorni | $0.40 × 30 | $12.00 |
Questi prezzi sono ipotetici, non quotazioni per un modello specifico. Se i tuoi utenti inviano messaggi più lunghi, o se la tua applicazione conserva una cronologia della conversazione in crescita, il conteggio dei token di input può aumentare.
Esempio pratico: generare articoli con un'API
Supponi che un flusso di lavoro editoriale invii un brief lungo e materiale di riferimento per un totale di 12,000 token di input, poi riceva 3,000 token di output. Usando le stesse tariffe illustrative:
- Input: 12,000 ÷ 1,000,000 × $1 = $0.012.
- Output: 3,000 ÷ 1,000,000 × $4 = $0.012.
- Una generazione: $0.024.
- 50 generazioni: $1.20.
Questa stima copre solo queste chiamate al modello. Richieste di ricerca, riscritture, chiamate di traduzione, tentativi ripetuti, generazione di immagini e altri servizi si aggiungono al totale.
Come misurare i token invece di fare supposizioni
La maggior parte delle risposte delle API di AI espone informazioni sull'utilizzo, come i conteggi dei token di input e di output. Registra questi conteggi da un insieme rappresentativo di richieste reali, poi calcola la media o un valore a percentile elevato. Ad esempio, registra nel log il nome del modello, il tipo di operazione, i token di input, i token di output e se la richiesta è riuscita. Evita di registrare inutilmente il contenuto privato dei prompt.
Un tokenizer può aiutarti a stimare la lunghezza del prompt prima di inviarlo, ma il rapporto di utilizzo dell'API è generalmente la fonte migliore per le unità di fatturazione effettive. I conteggi dei token non sono identici ai conteggi delle parole, e il rapporto cambia con la lingua, la formattazione e il codice.
Perché la tua fattura potrebbe differire
| Causa | Cosa controllare |
|---|---|
| Token di input in cache | Se il provider addebita i token in cache a una tariffa diversa |
| Elaborazione batch | Se si applica uno sconto per batch asincrono |
| Nuovi tentativi e richieste non riuscite | Se hanno consumato token fatturabili |
| Cronologia della conversazione lunga | Se l'intera cronologia viene reinviata a ogni turno |
| Chiamate agli strumenti o input multimodali | Se si applicano tipi di token aggiuntivi o tariffe separate |
| Modifiche al modello | Se il modello implementato ha tariffe di input/output diverse |
| Tasse, crediti e livelli gratuiti | Se influiscono sull'importo effettivamente fatturato |
Importante: il calcolatore usa un semplice modello di prezzo input/output. Non modella separatamente i token in cache, la fatturazione dei token di ragionamento, i costi per audio, immagini o video, o le commissioni minime specifiche del provider.
Come ridurre i costi API senza perdere qualità
Riduci il contesto ripetuto. Invia le istruzioni e i documenti necessari per l'attività corrente, invece di allegare automaticamente ogni scambio precedente.
Imposta limiti di output ragionevoli. Un'attività di estrazione concisa raramente necessita dello stesso margine di output di un lungo report. Verifica che la risposta contenga comunque tutte le informazioni richieste.
Usa il modello giusto per ogni passaggio. Classificazione, riepilogo e ragionamento complesso possono avere requisiti di qualità e costo diversi. Esegui benchmark sui tuoi esempi prima di cambiare modello.
Metti in cache le informazioni riutilizzabili quando supportato. Controlla le regole del provider per la cache dei prompt e misura lo sconto reale invece di presumere che ogni richiesta ne abbia diritto.
Monitora l'utilizzo in produzione. Tieni traccia dei token e dei costi per funzione, utente o job. Imposta avvisi per picchi improvvisi e rivedi i cicli che riprovano eccessivamente.
FAQ
Il calcolatore mostra i prezzi dei modelli in tempo reale?
No. Inserisci le tariffe di input e output più recenti dalla documentazione dei prezzi del tuo provider. I valori predefiniti sono esempi.
Cosa succede se il mio provider addebita in un'altra valuta?
Il calcolatore attuale visualizza USD. Se necessario, converti tu stesso le tariffe usando un tasso di cambio chiaramente documentato; il calcolatore non esegue la conversione di valuta.
Posso stimare il costo mensile dalle richieste giornaliere?
Sì. Moltiplica la stima giornaliera per il numero di giorni in cui prevedi che l'applicazione venga eseguita. Un mese di 30 giorni è una convenzione utile per la pianificazione, non una garanzia dell'utilizzo effettivo.
Perché i token di output sono spesso più costosi?
I provider possono impostare tariffe separate per la generazione dei token e l'elaborazione dell'input. Controlla sempre i prezzi attuali del modello specifico invece di presumere una tariffa unica condivisa.
Gli esempi pratici sono illustrativi. Conferma le unità di fatturazione, i prezzi attuali dei modelli e qualsiasi sconto direttamente con il provider dell'API prima di impegnarti in un budget.