
AI-API-Token-Kostenrechner: Schätzen Sie die Kosten für Eingabe- und Ausgabe-Token
Schätzen Sie die Ausgaben für AI-API anhand von Eingabe- und Ausgabe-Token, Anfragevolumen und Modellpreisen, mit praktischen Beispielen und Möglichkeiten zur Kostenreduktion.
Schätzen Sie die Kosten einer KI-API, bevor Sie sie einsetzen
Enter the rates published by your provider. Cached tokens, free tiers, batch discounts and taxes are excluded.
Der beworbene Preis eines KI-Modells wird üblicherweise pro Million Eingabe-Token und pro Million Ausgabe-Token angegeben. Diese Preise können erheblich voneinander abweichen, daher hängen die Kosten einer API-Anfrage davon ab, wie viel Kontext Sie senden und wie viel Text das Modell generiert.
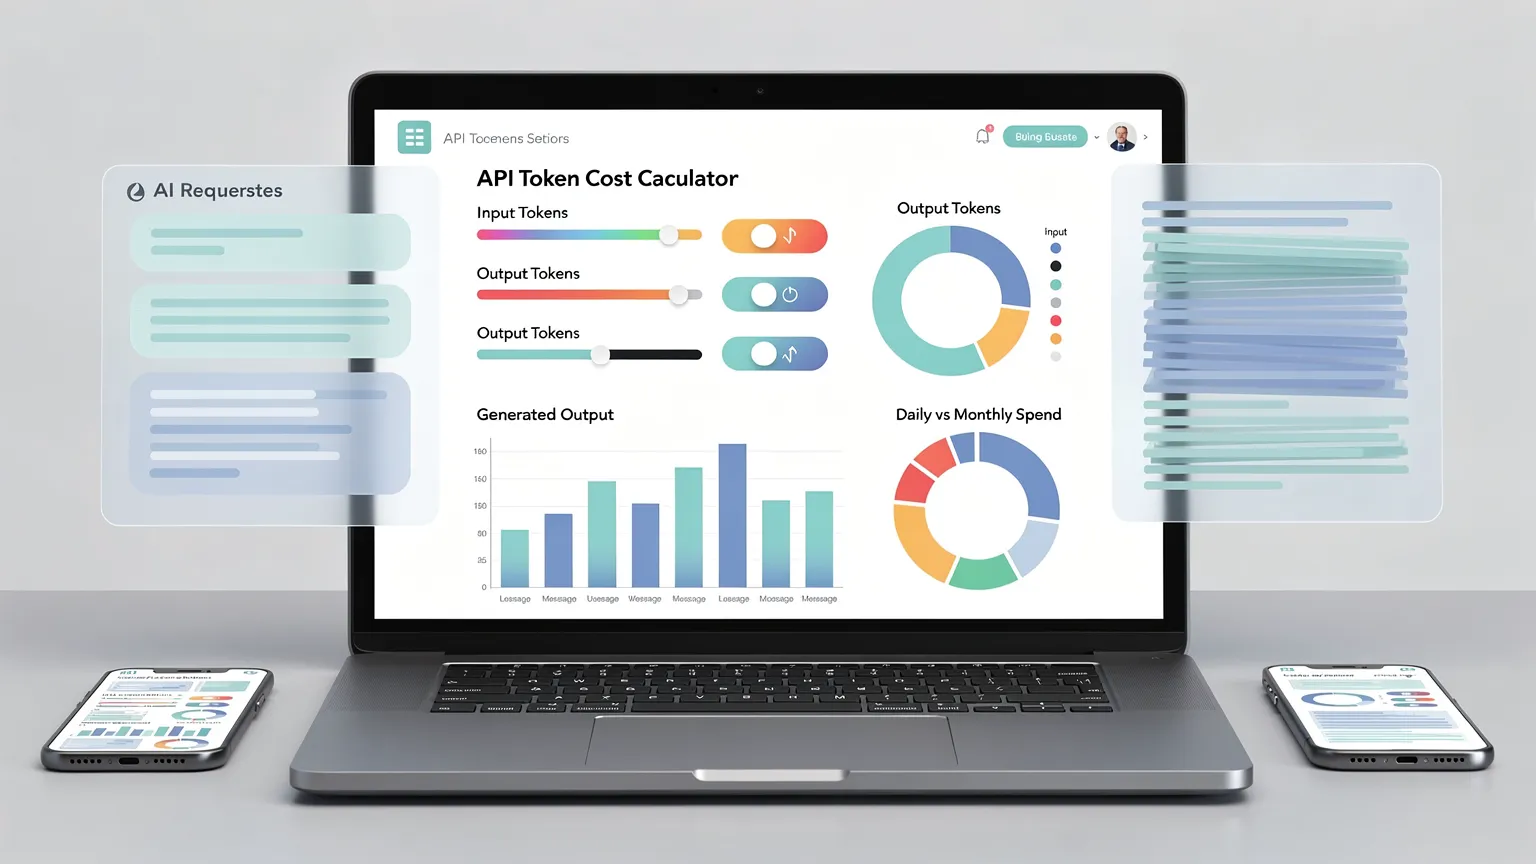
Verwenden Sie den obigen Rechner, um ein Tages- oder Monatsbudget zu schätzen. Ersetzen Sie die Beispielpreise durch die aktuellen Preise, die von Ihrem gewählten Anbieter und Modell veröffentlicht werden. Der Rechner ruft keine Live-Preise ab.
Schritt für Schritt: Berechnen Sie Ihr API-Budget
- Messen Sie die Eingabe-Token. Berücksichtigen Sie die Systemanweisungen, die Benutzernachricht, den Gesprächsverlauf, abgerufene Dokumente und jeden sonstigen Text, der an das Modell übermittelt wird.
- Messen Sie die Ausgabe-Token. Verwenden Sie die tatsächliche Anzahl der Ausgabe-Token aus Ihren API-Antworten oder schätzen Sie sie anhand eines repräsentativen Tests.
- Geben Sie die Anfragen pro Tag ein. Beginnen Sie mit der beobachteten Nutzung oder einer realistischen Prognose, nicht mit einem optimistischen Maximum.
- Geben Sie die Preise des Anbieters pro Million Token ein. Eingabe- und Ausgabepreise müssen getrennt eingegeben werden, in USD gemäß der aktuellen Anzeige des Rechners.
- Vergleichen Sie die Schätzung mit Ihrem Budget. Wiederholen Sie dies mit einer höheren Anzahl von Anfragen und längeren Eingabeaufforderungen, um mögliches Wachstum zu verstehen.
Die grundlegende Formel lautet:
Kosten pro Anfrage = (Eingabe-Token ÷ 1.000.000 × Eingaberate) + (Ausgabe-Token ÷ 1.000.000 × Ausgaberate).
Multiplizieren Sie das Ergebnis mit der Anzahl der Anfragen, um die gesamten Nutzungskosten zu schätzen.
Durchgerechnetes Beispiel: ein KI-Assistent für den Kundensupport
Angenommen, ein Support-Assistent verwendet 2.000 Eingabe-Token und 500 Ausgabe-Token pro Anfrage. Nur zur Veranschaulichung seien die Preise $1 pro Million Eingabe-Token und $4 pro Million Ausgabe-Token.
| Position | Berechnung | Kosten |
|---|---|---|
| Eingabe pro Anfrage | 2.000 ÷ 1.000.000 × $1 | $0,002 |
| Ausgabe pro Anfrage | 500 ÷ 1.000.000 × $4 | $0,002 |
| Gesamt pro Anfrage | $0,002 + $0,002 | $0,004 |
| 100 Anfragen pro Tag | 100 × $0,004 | $0,40/Tag |
| Schätzung für 30 Tage | $0,40 × 30 | $12,00 |
Diese Preise sind hypothetisch und keine Angebote für ein bestimmtes Modell. Wenn Ihre Benutzer längere Nachrichten senden oder Ihre Anwendung einen wachsenden Gesprächsverlauf speichert, kann die Anzahl der Eingabe-Token steigen.
Durchgerechnetes Beispiel: das Generieren von Artikeln mit einer API
Angenommen, ein Publikationsablauf übermittelt eine lange Vorgabe und Referenzmaterial mit insgesamt 12.000 Eingabe-Token und erhält dann 3.000 Ausgabe-Token. Mit denselben illustrativen Preisen:
- Eingabe: 12.000 ÷ 1.000.000 × $1 = $0,012.
- Ausgabe: 3.000 ÷ 1.000.000 × $4 = $0,012.
- Eine Generierung: $0,024.
- 50 Generierungen: $1,20.
Diese Schätzung umfasst nur diese Modellaufrufe. Rechercheanfragen, Neufassungen, Übersetzungsaufrufe, Wiederholungsversuche, Bildgenerierung und andere Dienste kommen zu den Gesamtkosten hinzu.
So messen Sie Token, anstatt zu raten
Die meisten KI-API-Antworten liefern Nutzungsinformationen wie die Anzahl der Eingabe- und Ausgabe-Token. Erfassen Sie diese Werte aus einer repräsentativen Menge echter Anfragen und berechnen Sie dann den Durchschnitt oder einen hohen Perzentilwert. Protokollieren Sie beispielsweise den Modellnamen, den Vorgangstyp, die Eingabe-Token, die Ausgabe-Token und ob die Anfrage erfolgreich war. Vermeiden Sie es, private Eingabeaufforderungsinhalte unnötig zu protokollieren.
Ein Tokenizer kann Ihnen helfen, die Länge einer Eingabeaufforderung vor dem Senden zu schätzen, aber der Nutzungsbericht der API ist in der Regel die bessere Quelle für die tatsächlichen Abrechnungseinheiten. Token-Zahlen sind nicht mit Wortzahlen identisch, und das Verhältnis ändert sich je nach Sprache, Formatierung und Code.
Warum Ihre Rechnung abweichen kann
| Ursache | Was zu prüfen ist |
|---|---|
| Zwischengespeicherte Eingabe-Token | Ob der Anbieter zwischengespeicherte Token zu einem anderen Preis berechnet |
| Stapelverarbeitung | Ob ein Rabatt für asynchrone Stapelverarbeitung gilt |
| Wiederholungsversuche und fehlgeschlagene Anfragen | Ob sie abrechenbare Token verbraucht haben |
| Langer Gesprächsverlauf | Ob der gesamte Verlauf bei jedem Zug erneut gesendet wird |
| Tool-Aufrufe oder multimodale Eingaben | Ob zusätzliche Token-Typen oder separate Gebühren gelten |
| Modelländerungen | Ob das eingesetzte Modell andere Eingabe-/Ausgaberaten hat |
| Steuern, Guthaben und kostenlose Tarife | Ob sie den tatsächlich in Rechnung gestellten Betrag beeinflussen |
Wichtig: Der Rechner verwendet ein einfaches Eingabe-/Ausgabe-Preismodell. Er modelliert nicht separat zwischengespeicherte Token, die Abrechnung von Reasoning-Token, Audio-, Bild- oder Videogebühren oder anbieterspezifische Mindestgebühren.
So senken Sie die API-Kosten, ohne die Qualität zu verlieren
Kürzen Sie wiederholten Kontext. Senden Sie die für die aktuelle Aufgabe benötigten Anweisungen und Dokumente, anstatt automatisch jeden früheren Austausch anzuhängen.
Legen Sie sinnvolle Ausgabegrenzen fest. Eine prägnante Extraktionsaufgabe benötigt selten denselben Ausgabenspielraum wie ein langer Bericht. Prüfen Sie, dass die Antwort weiterhin alle erforderlichen Informationen enthält.
Verwenden Sie für jeden Schritt das richtige Modell. Klassifizierung, Zusammenfassung und komplexes Reasoning können unterschiedliche Qualitäts- und Kostenanforderungen haben. Führen Sie Benchmarks anhand Ihrer eigenen Beispiele durch, bevor Sie die Modelle wechseln.
Speichern Sie wiederverwendbare Informationen zwischen, sofern unterstützt. Prüfen Sie die Regeln des Anbieters zum Prompt-Caching und messen Sie den tatsächlichen Rabatt, anstatt anzunehmen, dass jede Anfrage dafür infrage kommt.
Überwachen Sie die Nutzung in der Produktion. Verfolgen Sie Token und Kosten pro Funktion, Benutzer oder Auftrag. Legen Sie Warnungen für plötzliche Spitzen fest und überprüfen Sie Schleifen, die übermäßig oft wiederholen.
FAQ
Zeigt der Rechner Live-Modellpreise an?
Nein. Geben Sie die neuesten Eingabe- und Ausgaberaten aus der Preisdokumentation Ihres Anbieters ein. Die Standardwerte sind Beispiele.
Was, wenn mein Anbieter in einer anderen Währung abrechnet?
Der aktuelle Rechner zeigt USD an. Wenden Sie die Raten bei Bedarf selbst anhand eines klar dokumentierten Wechselkurses um; der Rechner führt keine Währungsumrechnung durch.
Kann ich die Monatskosten aus den täglichen Anfragen schätzen?
Ja. Multiplizieren Sie die tägliche Schätzung mit der Anzahl der Tage, für die die Anwendung voraussichtlich läuft. Ein Monat mit 30 Tagen ist eine nützliche Planungskonvention, keine Garantie für die tatsächliche Nutzung.
Warum sind Ausgabe-Token oft teurer?
Anbieter können für die Generierung von Token und die Verarbeitung der Eingabe unterschiedliche Preise festlegen. Prüfen Sie stets die aktuellen Preise des jeweiligen Modells, anstatt von einem gemeinsamen Preis auszugehen.
Die durchgerechneten Beispiele dienen der Veranschaulichung. Bestätigen Sie Abrechnungseinheiten, aktuelle Modellpreise und etwaige Rabatte direkt beim API-Anbieter, bevor Sie sich auf ein Budget festlegen.