
AI API Token Cost Calculator: Estimer Input- og Output-omkostninger
Estimer AI API-forbrug fra input- og output-tokens, forespørgselsvolumen og modelpriser, med praktiske eksempler og måder at reducere omkostninger.
Anslå omkostningerne ved en AI API, før du udruller den
Enter the rates published by your provider. Cached tokens, free tiers, batch discounts and taxes are excluded.
En AI-model annoncerede pris udtrykkes normalt pr. million input-tokens og pr. million output-tokens. Disse satser kan variere betydeligt, så omkostningerne ved en API-anmodning afhænger af både, hvor meget kontekst du sender, og hvor meget tekst modellen genererer.
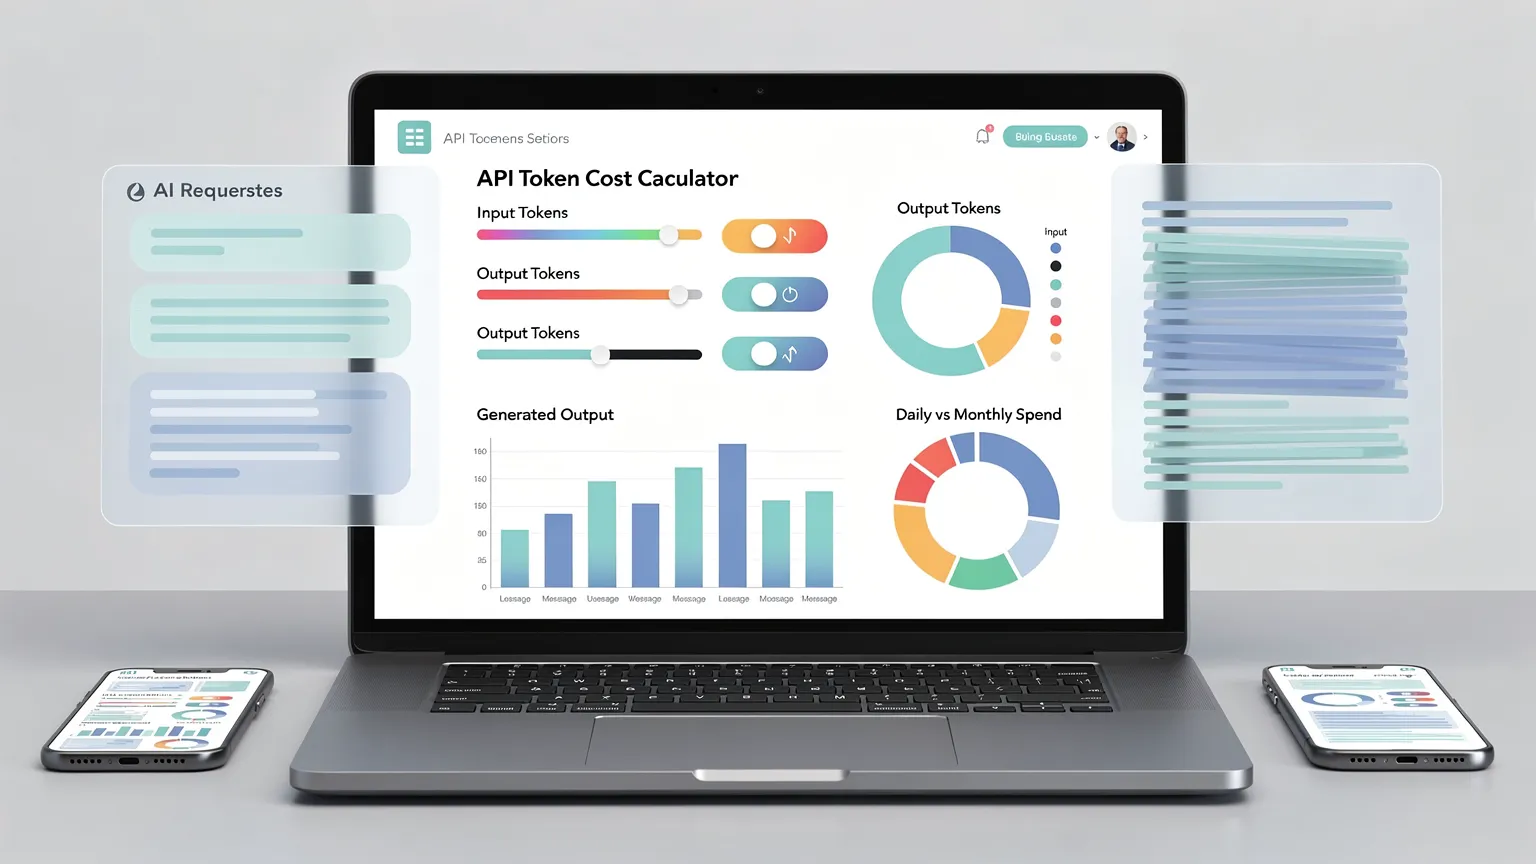
Brug beregneren ovenfor til at anslå et dagligt eller månedligt budget. Erstat eksempelsatserne med de aktuelle priser, som din valgte udbyder og model har offentliggjort. Beregneren henter ikke live-priser.
Trin for trin: beregn dit API-budget
- Mål input-tokens. Inkludér systeminstruktioner, brugerbeskeden, samtalens historik, hentede dokumenter og enhver anden tekst, der indsendes til modellen.
- Mål output-tokens. Brug det faktiske antal output-tokens fra dine API-svar, eller anslå det ud fra en repræsentativ test.
- Indtast anmodninger pr. dag. Start med observeret brug eller en realistisk prognose, ikke et optimistisk maksimum.
- Indtast udbyderens priser pr. million tokens. Input- og outputpriser skal indtastes separat, i USD i henhold til beregnerens aktuelle visning.
- Sammenlign anslaget med dit budget. Gentag med et højere antal anmodninger og længere prompts for at forstå mulig vækst.
Den grundlæggende formel er:
Omkostning pr. anmodning = (input-tokens ÷ 1.000.000 × input-sats) + (output-tokens ÷ 1.000.000 × output-sats).
Multiplicér resultatet med antallet af anmodninger for at anslå de samlede forbrugsomkostninger.
Eksempel gennemregnet: en AI-assistent til kundesupport
Antag, at en supportassistent bruger 2.000 input-tokens og 500 output-tokens pr. anmodning. For illustrationens skyld antager vi, at satserne er $1 pr. million input-tokens og $4 pr. million output-tokens.
| Element | Beregning | Omkostning |
|---|---|---|
| Input pr. anmodning | 2.000 ÷ 1.000.000 × $1 | $0,002 |
| Output pr. anmodning | 500 ÷ 1.000.000 × $4 | $0,002 |
| I alt pr. anmodning | $0,002 + $0,002 | $0,004 |
| 100 anmodninger pr. dag | 100 × $0,004 | $0,40/dag |
| 30-dages anslag | $0,40 × 30 | $12,00 |
Disse priser er hypotetiske, ikke tilbud for nogen bestemt model. Hvis dine brugere sender længere beskeder, eller din applikation bevarer en voksende samtalehistorik, kan antallet af input-tokens stige.
Eksempel gennemregnet: generering af artikler med en API
Antag, at en udgivelsesarbejdsgang indsender en lang brief og referencestof, der i alt udgør 12.000 input-tokens, og derefter modtager 3.000 output-tokens. Med de samme illustrative satser:
- Input: 12.000 ÷ 1.000.000 × $1 = $0,012.
- Output: 3.000 ÷ 1.000.000 × $4 = $0,012.
- Én generering: $0,024.
- 50 genereringer: $1,20.
Det anslag dækker kun disse modelkald. Forsøgsanmodninger, omskrivninger, oversættelseskald, fornyede forsøg, billedgenerering og andre tjenester lægger sig til det samlede beløb.
Sådan måler du tokens i stedet for at gætte
De fleste AI API-svar eksponerer forbrugsinformation såsom antal input- og output-tokens. Registrér disse antal fra et repræsentativt sæt af faktiske anmodninger, og beregn derefter gennemsnittet eller en værdi i et højt percentil. Registrér for eksempel modellnavnet, operationstypen, input-tokens, output-tokens og, hvorvidt anmodningen lykkedes. Undgå unødigt at logge privat promptindhold.
En tokenizer kan hjælpe dig med at anslå promptlængden, før du sender den, men API'ets forbrugsrapport er generelt den bedre kilde til de faktiske afregningsenheder. Antallet af tokens er ikke identisk med antallet af ord, og forholdet ændrer sig med sprog, formatering og kode.
Hvorfor din regning kan afvige
| Årsag | Hvad du skal tjekke |
|---|---|
| Cachede input-tokens | Hvorvidt udbyderen opkræver en anden sats for cachede tokens |
| Batch-behandling | Hvorvidt en rabat for asynkron batch anvendes |
| Fornyede forsøg og mislykkede anmodninger | Hvorvidt de har forbrugt fakturerbare tokens |
| Lang samtalehistorik | Hvorvidt hele historikken gensendes ved hver tur |
| Værktøjskald eller multimodale input | Hvorvidt der anvendes yderligere tokentyper eller separate gebyrer |
| Modelændringer | Hvorvidt den udrullede model har andre input/output-satser |
| Skatter, kreditter og gratis niveauer | Hvorvidt de påvirker det beløb, der faktisk faktureres |
Vigtigt: beregneren bruger en simpel input/output-prismodel. Den modellerer ikke separat cachede tokens, fakturering af reasoning-tokens, lyd, billede- eller videoafgifter eller udbyderspecifikke minimumsgebyrer.
Sådan reducerer du API-omkostninger uden at miste kvalitet
Beskær gentaget kontekst. Send de instruktioner og dokumenter, der er nødvendige for den aktuelle opgave, i stedet for automatisk at vedhæfte hver tidligere udveksling.
Sæt fornuftige outputgrænser. En kort udtræksopgave kræver sjældent den samme outputtilladelse som en lang rapport. Validér, at svaret stadig indeholder alle påkrævede oplysninger.
Brug den rigtige model til hvert trin. Klassificering, opsummering og kompleks resonnement kan have forskellige kvalitets- og omkostningskrav. Benchmark på dine egne eksempler, før du skifter model.
Cach genbrugelig information, når det understøttes. Tjek udbyderens regler for prompt-caching, og mål den faktiske rabat i stedet for at antage, at hver anmodning kvalificerer sig.
Overvåg forbrug i produktion. Følg tokens og omkostninger pr. funktion, bruger eller job. Sæt advarsler for pludselige stigninger, og gennemgå løkker, der fornyer forsøg overdrevent.
Ofte stillede spørgsmål
Viser beregneren live-modelpriser?
Nej. Indtast de nyeste input- og outputsatser fra din udbyders prisdokumentation. Standardværdierne er eksempler.
Hvad hvis min udbyder opkræver i en anden valuta?
Den aktuelle beregner viser USD. Konvertér selv satserne ved at bruge en klart dokumenteret vekselkurs, hvis det er nødvendigt; beregneren udfører ikke valutakonvertering.
Kan jeg anslå månedlig omkostning ud fra daglige anmodninger?
Ja. Multiplicér det daglige anslag med antallet af dage, hvor du forventer, at applikationen kører. En 30-dages måned er en nyttig planlægningskonvention, ikke en garanti for det faktiske forbrug.
Hvorfor er output-tokens ofte dyrere?
Udbydere kan fastsætte separate satser for at generere tokens og behandle input. Tjek altid den aktuelle prissætning for den specifikke model i stedet for at antage én fælles sats.
De gennemregnede eksempler er illustrative. Bekræft afregningsenheder, aktuelle modelpriser og eventuelle rabatter direkte hos API-udbyderen, før du forpligter dig til et budget.